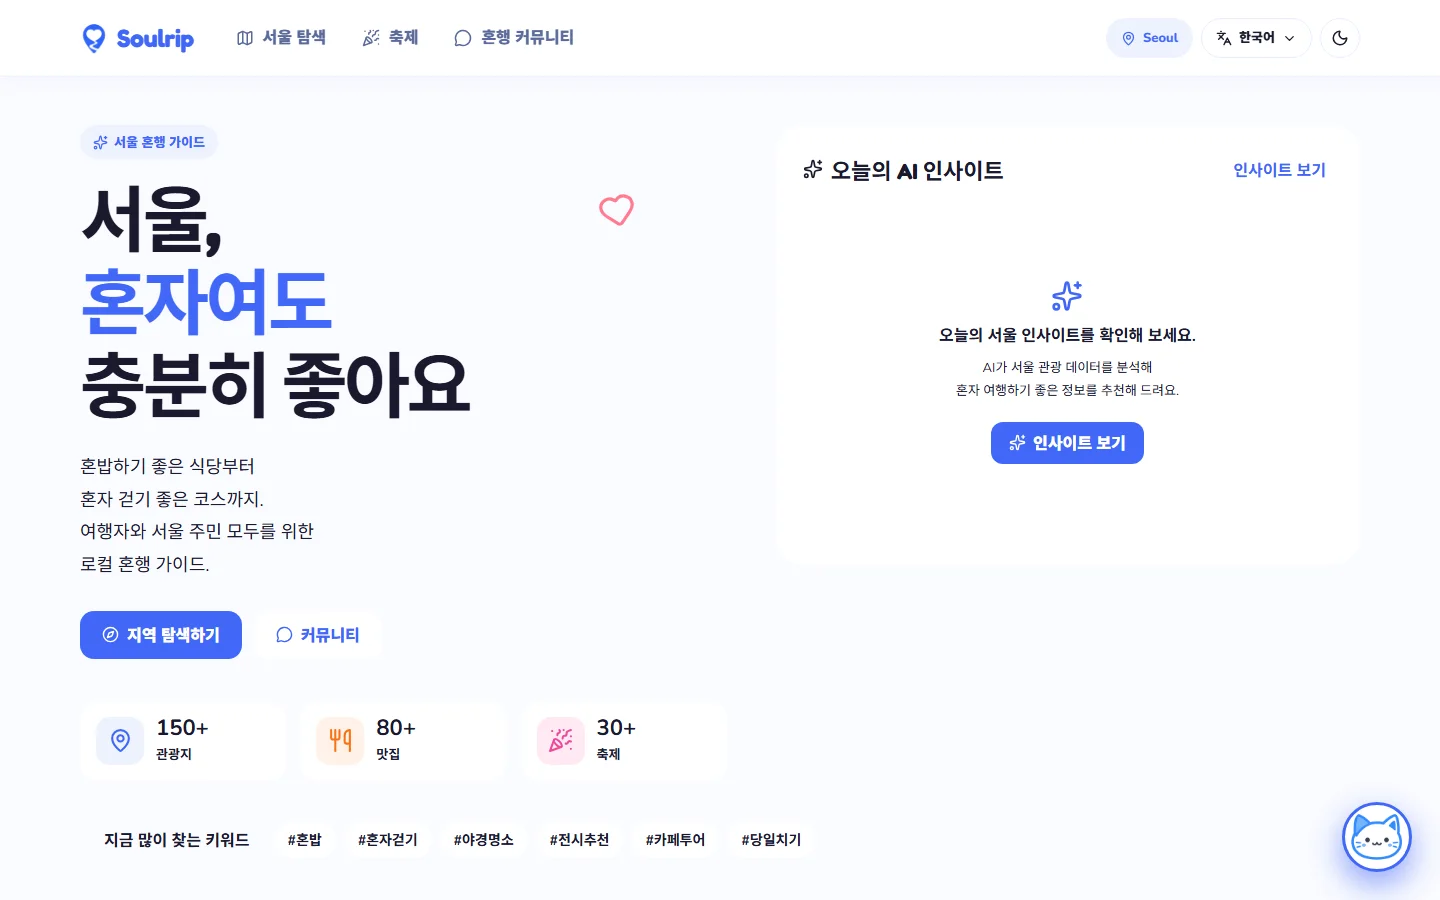
Soulrip은 혼자 서울을 여행하는 사람을 위한 관광 커뮤니티 가이드다. 이름에 Solo, Seoul, Trip을 함께 담았다. SSAFY 16기 StartCamp에서 3명이 3일 동안 만들었고, 나는 팀장을 맡아 기획부터 프론트·백엔드 구현까지 같이 했다. 팀원 세 명 모두 프론트와 백엔드를 나눠 맡지 않고 양쪽을 함께 구현했다.
3일 안에 요구사항은 다 채웠지만, 챗봇을 직접 써볼수록 아쉬움이 커졌다. 그래서 두 달 뒤 프로젝트를 다시 열어 챗봇을 RAG 구조로 바꾸고, 평가를 기준으로 프롬프트를 고치고, AI 코딩 도구가 일관되게 작업하도록 하네스를 붙였다. 이 글은 그 과정의 기록이다.
v1: 3일 안에 만든 것#
3일이라는 시간 안에서 가장 먼저 한 일은 만들 것과 만들지 않을 것을 나누는 것이었다. RFP 원문을 그대로 LLM에 넣고, 단계마다 출력 형식을 지정해 산출물을 만들었다.
- 요구사항 분석 — 필수 · 선택 · 제약 · 검토 항목으로 분류한 RFP 핵심 요구 추출표
- 아이디어 도출 — "3일 · 신입 3명 · Copilot 사용" 조건을 넣은 난이도 · 실현 가능성 · 임팩트 표
- MVP 정의 — MoSCoW로 범위를 고정한 Must · Should · Could · Won't 표
- WBS 작성 — 날짜 · 납기 · 담당 기준의 작업 분해와 일정표
선택 기능은 "실현 가능성 × 체감 효과" 점수로 골랐다. 게시글 검색과 축제 캘린더가 40점으로 가장 높았고, 데이터 시각화 대시보드는 8점이라 제외했다.
| Must have | Should / Could | Won't have |
|---|---|---|
| 서울 JSON 데이터 연동 | 오늘의 AI 혼행 인사이트 | 회원가입 · 로그인 / JWT |
| 익명 혼행 커뮤니티 CRUD | 게시글 유형 · 검색 · 조회수 | 데이터 시각화 대시보드 |
| 지역 정보 챗봇 API / UI | 지도 시각화 · 축제 캘린더 | 외부 날씨 API |
| Vue 3 + FastAPI + SQLite | 북마크 · 공유 · 좋아요 · 태그 | WebSocket 실시간 알림 |
| 배포 · 보안 · 산출물 제출 | 다국어 · 이미지 첨부 | 서울 외 권역 |
Day 1(07.14)에 RFP 분석과 화면 · DB · API 설계, Day 2에 커뮤니티 CRUD · AI 인사이트 · 챗봇 · 지도 · 캘린더, Day 3에 통합 테스트와 Netlify · Render 배포까지 진행했다. 완료 기준은 "CRUD 정상 동작 · JSON 데이터 조회 · AI 챗봇 응답 · 모바일 UI · 배포 URL 정상 동작"으로 미리 정해두었다.
v1 챗봇은 어떻게 동작했나#
v1 챗봇(POST /api/v1/chat)은 사실 검색 엔진 + LLM 요약에 가까웠다. 질문에서 검색어를 뽑고, SQLite에서 ILIKE로 찾은 결과를 Gemini에 넘겨 답을 만들었다.
PARTICLES = ("에서", "으로", "에게", "에는", "이랑", "하고", "의", "을", "를", "은", "는", "이", "가", "에")

def _search_terms(message: str) -> list[str]:
    terms = []
    for raw in re.findall(r"[0-9A-Za-z가-힣]+", message):
        term = raw
        for particle in PARTICLES:          # 조사를 떼어낸다
            if term.endswith(particle) and len(term) > len(particle) + 1:
                term = term[: -len(particle)]
                break
        if len(term) >= 2 and term not in STOP_WORDS and term not in terms:
            terms.append(term)
    return terms[:8]                        # 검색어는 최대 8개
뽑은 검색어로 장소 이름 · 주소 · 자치구 · 유형 컬럼을 ILIKE 검색하고, 겹치는 검색어 수로 순위를 매겼다. 영어나 일본어 질문은 먼저 한국어 검색어로 번역한 뒤 같은 과정을 거쳤다.
반면 오늘의 AI 인사이트는 처음부터 꽤 단단하게 만들었다. 장소 8개와 축제 4개를 뽑아 모델에 넘기고, 출력은 JSON Schema(strict)로 강제했다. 응답에 들어온 image_url이 입력 데이터에 있던 URL인지 다시 검사해서, 모델이 이미지 주소를 지어내지 못하게 했다. 이 "입력 데이터 밖으로 나가지 못하게 막는다"는 원칙이 이후 RAG 설계의 출발점이 됐다.
RAG를 도입한 이유#
v1 챗봇을 직접 써보면서 문제를 네 가지로 정리했다.
1. 표현이 다르면 찾지 못했다. "비 오는 날 혼자 조용히 있을 만한 곳"처럼 의미는 분명한데 데이터의 단어와 겹치지 않는 질문은 검색 결과가 비었다. 결과가 없으면 인기 장소 목록으로 fallback 했기 때문에, 질문과 상관없는 추천이 나오기도 했다.
2. 규칙이 계속 늘어났다. 조사 목록과 불용어 사전을 고칠 때마다 다른 질문이 깨졌다. 형태소 분석을 흉내 내는 규칙을 계속 덧붙이는 건 검색 품질을 올리는 방법이 아니라고 판단했다.
3. 근거가 될 '설명'이 없었다. 제공된 JSON은 이름 · 주소 · 유형 · 좌표 같은 구조화된 값이 중심이다. 그래서 답변이 "관련 결과를 찾았어요: A, B, C" 같은 나열에 머물렀다. 왜 혼자 가기 좋은지, 언제 가면 좋은지를 말해줄 문서가 없었다.
4. 다국어 질문은 호출이 하나 더 필요했다. 번역을 거쳐야 검색이 가능해서, 외국어 질문은 LLM 호출이 한 번 더 붙었다.
결국 문제는 "답변을 더 잘 쓰는 것"이 아니라 "질문과 의미가 가까운 근거를 찾는 것"이었다. 그래서 키워드 매칭을 의미 검색으로 바꾸고, 공식 관광 자료를 근거 문서로 넣는 RAG 구조를 택했다.
RAG 고찰: 무엇을 RAG로 풀고, 무엇을 풀지 않을까#
RAG를 붙이기로 하고 가장 오래 고민한 건 모든 데이터를 벡터 DB에 넣을 것인가였다. 결론은 "아니다"였다.
축제 일정이나 주소, 좌표는 정확한 값이 중요하다. "이번 주말 축제"를 물으면 날짜 조건으로 정확히 걸러야 하는데, 임베딩 유사도는 날짜 범위를 이해하지 못한다. 반대로 관광 가이드나 후기는 같은 의미를 다른 표현으로 쓰기 때문에 의미 검색이 맞다. 날씨나 혼잡도는 시점이 지나면 틀린 정보가 되니 문서로 저장할 대상이 아니다.
그래서 데이터를 세 갈래로 나눴다.
| 데이터 | 형태 | 가져오는 방법 |
|---|---|---|
| 장소 · 축제 · 커뮤니티 글 | 구조화 데이터 | SQL 조건 조회 (기존 v1 경로 유지) |
| 관광 가이드 · 공식 문서 · 후기 | 비정형 텍스트 | 임베딩 검색 (RAG) |
| 날씨 · 혼잡도 | 실시간 수치 | 외부 API 조회 |
이 판단에는 SSAFY에서 따로 했던 기업 보고서 RAG 실습의 경험이 컸다. 거기서 청크 크기를 500 → 800, overlap을 50 → 100으로 늘리고 제목 · 표 머리글 · 각주를 함께 유지하도록 바꿨더니, 같은 질문 3개 기준으로 검색 정밀도는 0.769 → 0.944로 올랐다. 그런데 답변 충실도는 0.952 → 0.933으로 오히려 조금 떨어졌다. 검색이 좋아졌다고 답변이 좋아지는 건 아니다. 그래서 Soulrip에서도 검색과 생성을 따로 평가하기로 했다. (이 수치는 기업 보고서 실습의 결과이고, Soulrip 자체의 성과가 아니다.)
v2 RAG 파이프라인#
- 자료 수집: 서울 열린데이터광장(관광지 · 축제 · 교통), 서울관광재단 공식 가이드와 행사 정보, 실제 방문 후기
- 전처리: 텍스트 정제, 중복 제거, 청킹. 제목과 상위 문맥이 청크에서 떨어지지 않도록 했다
- 임베딩 · 저장: OpenAI Embedding(text-embedding-3)으로 벡터화해 SQLite에 저장. 기존 스택을 유지하려고 별도 벡터 DB를 들이지 않았다
- 검색: 질문 의미 기반으로 관련 문서 Top-k를 가져오고, 장소 · 축제 질문이면 SQL 조회 결과를 함께 붙인다
- 답변 생성: GPT-4o-mini가 검색된 근거로만 답한다
프롬프트는 "무엇을 답하지 않을지"를 먼저 적었다.
당신은 서울 여행 전문 AI 어시스턴트입니다.
제공된 공식 데이터와 문서를 기반으로만 답변하세요.
답변은 다음 형식으로 작성합니다.

1) 요약 답변
2) 추천 장소 / 축제 / 일정 (이유 포함)
3) 추가 팁
4) 출처 링크

모르는 내용은 "자료에서 확인할 수 없습니다."라고 답하세요.
출력 형식을 고정한 이유는 두 가지다. 화면에서 바로 카드로 보여줄 수 있어야 했고, 출처 링크 칸이 있으면 모델이 근거 없는 문장을 쓰기 어려워진다.
AI 성능 개선: 평가 없이 "좋아졌다"고 말하지 않기#
프롬프트를 고칠 때마다 몇 개 질문을 던져보고 "괜찮아진 것 같다"고 판단하면, 다른 유형의 질문이 망가진 걸 놓친다. 그래서 LangSmith에서 실제 사용자 질문 유형으로 테스트 세트를 만들고, 기본 프롬프트와 개선 프롬프트를 같은 세트로 비교했다.
| 평가 항목 | 기본 프롬프트 | 개선 프롬프트 |
|---|---|---|
| 정확성 (Groundedness) | 0.71 | 0.91 |
| 관련성 (Relevance) | 0.68 | 0.89 |
| 사용자 만족도 (수동 평가, 5점) | 3.6 | 4.5 |
점수를 올린 변경은 세 가지였다.
- 사용자 의도 분류 추가 — 질문을 관광지 · 축제 · 교통 · 일정으로 먼저 나누고, 의도에 따라 검색 대상과 답변 형식을 바꿨다. "이번 주말 축제"는 날짜 조건 조회를, "혼자 가기 좋은 곳"은 의미 검색을 타게 된다.
- 출처 명시를 강조한 프롬프트 — 추천마다 근거 문서를 붙이게 하자, 근거 없이 지어내는 문장이 눈에 띄게 줄었다.
- LangSmith 로그로 실패 사례 보완 — 모호한 질문이나 여러 의도가 섞인 복합 질문이 어느 단계에서 무너지는지 입력 · 출력을 추적해 프롬프트와 분기를 고쳤다.
흐름은 LangGraph로 의도 분류 → 검색 → 답변 생성 → 검토 단계로 나눴다. Agent 실습에서 검토 단계를 늘릴수록 품질은 오르지만 호출 횟수와 응답 시간도 함께 늘어나는 걸 확인했기 때문에, 검토 횟수와 종료 조건을 상태값으로 관리해 무한히 고치지 않도록 했다.
오늘의 AI 인사이트도 데이터를 넓혔다#
v1 인사이트는 제공 JSON에서 무작위로 뽑은 장소와 축제만 근거로 썼다. v1에서 Won't have로 미뤘던 외부 데이터를 v2에서 붙였다.
- 데이터: 서울 열린데이터광장에 더해 날씨 API(기온 · 강수 · 미세먼지), 주변 맛집 정보, 방문 후기
- 분석: 인기 관광지 순위를 정적 목록에서 최근 트렌드 반영으로, 계절별 방문 비율을 월 단위에서 주 단위로 세분화
- 전달: "오늘은 관광객이 많아 한적한 실내 명소를 추천해요"처럼 날씨와 혼잡도를 근거로 한 한 줄 코멘트를 카드로 제공
입력 데이터에 없는 사실은 쓰지 않고, 이미지 URL은 입력에 있던 값만 쓴다는 v1의 원칙은 그대로 유지했다.
하네스: AI 코딩 에이전트가 같은 기준으로 일하게 만들기#
리팩토링을 하면서 AI 코딩 도구를 적극적으로 썼다. 문제는 도구가 요청마다 프로젝트 구조를 처음부터 추론한다는 점이었다. 그대로 두면 기존 Router → Schema → Service 흐름을 무시한 새 계층을 만들거나, 프론트가 쓰고 있는 응답 필드 이름을 바꾸는 식의 변경이 나오기 쉽다. 그렇다고 매번 긴 프롬프트로 맥락을 설명하는 것도 비용이었다.
그래서 프론트(Vue)와 백엔드(FastAPI) 저장소 각각에 하네스를 만들었다. AI가 작업할 때 필요한 맥락만 골라 읽도록 규칙을 네 계층으로 나눈 것이다.
Global     AGENTS.md + .github/copilot-instructions.md   모든 작업의 불변조건
Domain     docs/harness/features/*.md                    장소 · 축제 · 챗봇 · AI Insight 등 기능별 지식
Local      .github/instructions/*.instructions.md        특정 경로를 수정할 때의 코드 규칙
Workflow   .github/prompts/*.prompt.md                   신규 기능 · 버그 수정 · 리팩토링 · 리뷰 절차
예를 들어 백엔드 AGENTS.md의 챗봇 불변조건은 이렇게 적었다.
### Chatbot
- 챗봇은 저장된 서울 데이터와 커뮤니티 검색 결과를 근거로 답한다.
- 데이터에 없는 영업시간, 가격, 축제 날짜 등을 추측하지 않는다.
- AI 키가 없거나 호출이 실패하면 fallback 응답을 유지한다.
- 응답의 `sources`, `suggestions`, `used_ai` 계약을 보존한다.
- 지원 언어는 ko, en, ja, zh, fr, es, de 흐름을 유지한다.
하네스는 목적에 따라 세 가지로 나눠 만들었다.
- 기본 전체 하네스 — 프로젝트 구조, 기술 스택, API 규격, 데이터 형식, 비밀값 관리, 기능별 완료 조건
- AI 기능 하네스 — 챗봇 · RAG의 데이터 출처 제한, 출력 형식, 프롬프트 조건, AI 기능을 바꿔도 기존 API 계약을 유지할 것
- 리팩토링 하네스 — 유지해야 할 기능, 수정 범위 제한, 변경 뒤 같은 기능을 다시 실행해 확인할 것
마지막은 검증이다. AI가 만든 변경은 바로 채택하지 않고 요구사항, git diff, 실행 결과를 사람이 확인했다. 백엔드는 python -m compileall app scripts로 문법을 확인하고, Swagger(/docs)에서 요청 · 응답 스키마와 상태코드를 다시 봤다. 하네스 문서에도 "존재하지 않는 검증 명령을 임의로 가정하지 않는다"를 적어두었다.
하네스로 개발 속도가 몇 % 빨라졌는지는 재지 않았기 때문에 숫자로 말하지 않는다. 목표는 AI가 프로젝트 맥락을 매번 다시 추론하지 않게 하고, 구현과 리팩토링의 완료 조건을 명시해서 검토 비용과 시행착오를 줄이는 것이었다. 앞에서 말한 "새 계층을 만들지 않는다", "쓰고 있는 필드 이름을 바꾸지 않는다"도 그래서 전역 규칙에 명시했다.
회고#
3일 버전에서 잘한 것은 범위를 지킨 것이다. Won't have를 명확히 적어둔 덕분에 마지막 날까지 기능을 늘리지 않고 배포와 검증에 시간을 쓸 수 있었다.
다시 열어보며 배운 것은 세 가지다.
- RAG는 답변 문제가 아니라 검색 문제다. 먼저 "어떤 질문을 무엇으로 찾을지"를 나눠야 했고, 정확한 값이 필요한 데이터는 오히려 RAG 밖에 두는 게 맞았다.
- 평가가 없으면 개선이라고 말할 수 없다. 같은 테스트 세트로 비교하기 시작하면서 프롬프트 수정이 감이 아니라 근거가 있는 결정이 됐다. 검색 지표와 생성 지표를 따로 봐야 한다는 것도 실습에서 배운 그대로였다.
- AI가 빨리 만들수록 기준은 사람이 정해야 한다. 발표 회고 때 팀원 모두가 같은 말을 했다. AI 덕분에 개발은 빨라졌지만, 결과를 직접 검토하고 무엇을 지킬지 정하는 건 끝까지 사람의 몫이었다. 하네스는 그 기준을 문서로 남기는 방법이었다.
아쉬운 점도 남는다. 평가 세트가 아직 작아서 질문 유형이 늘어나면 점수가 달라질 수 있다. 인사이트 기능은 사용자가 실제로 무엇을 눌렀는지 측정하는 체계가 없어서, 개선 효과를 숫자로 확인하지 못했다. 다음에는 평가 세트를 질문 유형별로 늘리고, 인사이트 카드의 사용 로그부터 남길 생각이다.
링크#
- 서비스: soulrip.netlify.app
- Frontend: skyblue1232/soulrip-frontend
- Backend: skyblue1232/soulrip-backend
- API 문서: soulrip-backend.onrender.com/docs