AWS SAA 자료를 읽다 보면 서비스 이름이 너무 많아서 어디부터 이해해야 할지 막막해진다. 처음에는 서비스마다 정의를 외웠는데, 며칠 지나면 EC2와 ECS가, Multi-AZ와 Read Replica가 머릿속에서 섞였다.
방향을 바꾼 계기는 직접 해봤던 일이었다. 프로젝트에서 이미지 · 영상 로딩이 느려서 S3에 CloudFront를 붙이고 ACM 인증서로 HTTPS를 연결한 적이 있는데, 그때는 "CloudFront가 뭔지"보다 "S3에서 바로 받으면 왜 느린지"를 먼저 고민했다. 이름은 잊어도 그 이유는 오래 남았다.
그래서 이번에는 서비스를 외우지 않고, 웹 서비스를 만들 때 반드시 마주치는 질문 일곱 개로 묶었다. 각 묶음은 문제 → 선택 → 확인할 것 세 칸으로 정리했고, 헷갈린 개념은 AWS 공식 문서로 다시 확인했다. 10분 안에 설명할 수 있는 분량을 목표로 했다.
| # | 질문 | 다루는 서비스 |
|---|---|---|
| 1 | 내 코드를 어디에서 실행할까? | EC2 · ECS(Fargate) · Lambda |
| 2 | 파일은 어디에 두고 어떻게 전달할까? | S3 · CloudFront |
| 3 | 데이터를 보관하는 것과 빨리 읽는 것은? | RDS · ElastiCache |
| 4 | 누가 접근할 수 있고, 무엇을 할 수 있나? | VPC · 보안 그룹 · IAM |
| 5 | 트래픽이 늘거나 서버가 죽으면? | ALB · Auto Scaling · Multi-AZ |
| 6 | 느린 작업을 응답에서 떼어내려면? | SQS |
| 7 | 배포한 뒤에는 무엇을 봐야 하나? | CloudWatch · CloudTrail · 비용 |
AI로 배포 코드나 설정을 만들 수는 있어도, 무엇을 외부에 공개하고 어떤 권한을 주며 장애에 어떻게 대응할지는 직접 판단해야 한다. 이 노트는 그 판단의 근거를 정리하는 데 집중했다.
1. EC2 · ECS · Lambda — 내 코드를 어디에서 실행할까?#
EC2는 빌려 쓰는 가상 서버다. 운영체제 위에 Java, Node.js, Docker 등을 설치해 애플리케이션을 실행한다. 자유도가 높은 만큼 OS 패치, 실행 환경, 프로세스 관리 같은 운영 책임도 함께 생긴다.
ECS는 컨테이너를 배포하고 운영하는 서비스다. Docker 이미지로 만든 애플리케이션을 실행하고, 필요한 실행 개수를 유지하며 로드밸런서와 연결할 수 있다. ECS에서 Fargate를 쓰면 컨테이너가 올라갈 서버를 직접 관리하는 부담이 줄어든다. 그래도 CPU · 메모리, 실행 개수, 확장 정책은 여전히 직접 설계해야 한다.
Lambda는 이벤트가 발생하면 함수를 실행하는 서비스다. 이미지 업로드 후 썸네일 생성, 정기 작업, 간단한 API처럼 독립적인 작업에 어울린다. 서버 관리는 줄지만 실행 시간 제한과 초기 실행 지연(콜드 스타트)을 확인해야 한다.
| 상황 | 먼저 검토할 선택 |
|---|---|
| 서버 환경을 직접 구성하거나 세밀하게 제어해야 한다 | EC2 |
| Docker 기반 애플리케이션을 운영하고 싶다 | ECS, 서버 관리 부담을 줄이려면 Fargate |
| 이벤트에 따라 독립적인 함수를 실행한다 | Lambda |
핵심 포인트! 서버리스는 "서버가 없다"가 아니라 "서버 관리의 상당 부분을 AWS에 맡긴다"는 뜻이다. 이렇게 이해해야 하는 이유는 관리 책임과 비용 구조가 함께 움직이기 때문이다. Lambda는 실행된 만큼 비용을 내는 대신 실행 시간과 콜드 스타트라는 제약을 받는다. 그래서 요청이 하루 종일 꾸준히 들어오는 서비스라면 오히려 항상 떠 있는 컨테이너가 저렴할 수 있고, 선택 기준은 "무엇이 더 최신 기술인가"가 아니라 "트래픽 모양과 내가 감당할 운영 범위"로 정해진다.
2. S3 · CloudFront — 파일 저장과 전달을 나누자#
S3는 이미지, 영상, 백업 같은 객체를 저장하는 서비스다. EC2 디스크에 사용자 이미지를 저장하면 서버를 교체하거나 여러 대로 늘릴 때 파일이 특정 서버에 묶인다. 파일을 S3로 분리하면 애플리케이션 서버와 독립적으로 관리할 수 있다.
CloudFront는 콘텐츠를 사용자와 가까운 곳에서 전달하는 CDN이다. 캐시할 수 있는 콘텐츠는 엣지에 보관해 원본으로 가는 요청과 전달 지연을 줄인다. S3가 원본 창고라면 CloudFront는 여러 지역에 흩어진 전달 거점이다.
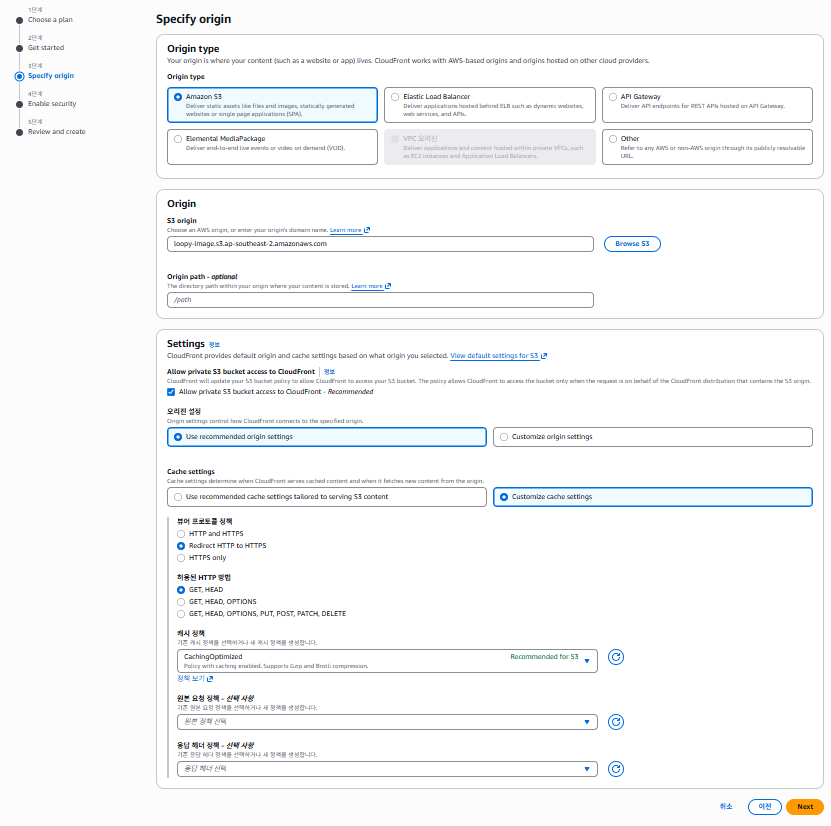
여기서 함께 정리해둔 세 가지가 있다.
- 비공개 S3 + OAC: 버킷 정책과 함께 설정해 지정한 CloudFront 배포만 S3 원본에 접근하게 한다. 단, OAC는 최종 사용자의 로그인 권한까지 검사하는 기능은 아니다.
- 캐시 갱신: 같은 주소의 파일을 바꾸면 이전 콘텐츠가 엣지에 남아 있을 수 있다. 파일명에 버전을 넣거나 캐시 무효화를 쓴다.
- Presigned URL: 서버가 유효기간과 작업 범위를 제한한 URL을 발급하면, 브라우저가 S3에 직접 업로드할 수 있다. 사용자에게 AWS 키를 넘길 필요가 없다.
핵심 포인트! S3는 저장, CloudFront는 전달이다. 둘을 나누는 이유는 "많이, 멀리, 반복해서 읽히는 파일"이라는 문제에 저장소 하나로는 답할 수 없기 때문이다. 원본은 한 곳에 비공개로 두고(OAC), 전달은 엣지 캐시가 맡고, 업로드는 서버가 권한을 확인한 뒤 Presigned URL로 위임하는 구조가 그래서 만들어진다. 다만 URL 발급만으로 업로드 보안이 끝나지는 않는다. 누가 올릴 수 있는지, 어느 경로에 얼마나 큰 파일을 올릴 수 있는지는 여전히 서버가 정해야 한다.
하나 더. S3 정적 호스팅만으로 Next.js의 서버 렌더링이나 서버 API가 실행되지는 않는다. 정적 파일을 저장하는 문제와 서버 코드를 실행하는 문제는 다르다.
3. RDS · ElastiCache — 보관하는 것과 빨리 읽는 것은 다르다#
RDS는 MySQL · PostgreSQL 같은 관계형 DB의 운영을 AWS가 일부 대신하는 서비스다. 백업과 유지보수 부담은 줄여주지만, 테이블 구조 · 인덱스 · SQL 성능은 여전히 개발자의 몫이다.
공부하면서 가장 많이 헷갈린 게 아래 두 구성이다.
| 구성 | 주된 목적 | 이해할 점 |
|---|---|---|
| RDS Multi-AZ DB 인스턴스 | 장애 대응 | 다른 AZ의 대기 DB로 자동 전환한다. 대기 DB는 조회를 분산하는 용도가 아니다 |
| Read Replica | 읽기 부하 분산 | 읽기 요청을 복제본으로 보낸다. 복제 지연 때문에 최신 데이터와 차이가 날 수 있다 |
여기서 말하는 Multi-AZ는 DB 인스턴스 구성이다. 읽기를 지원하는 별도의 Multi-AZ DB 클러스터 구성도 있어서, "Multi-AZ는 무조건 조회 불가"로 외우면 틀린다. 이 부분은 공식 문서를 다시 읽고 고쳐 적었다.
ElastiCache는 자주 쓰는 데이터를 빠르게 조회하기 위한 관리형 캐시다. 매번 계산할 필요가 없는 인기 게시글 목록을 캐시하면 DB 요청을 줄일 수 있다. 캐시의 핵심은 저장이 아니라 최신성을 어떻게 유지하느냐다. TTL은 캐시의 유효기간이고, 무효화는 원본이 바뀌었을 때 오래된 캐시를 지우거나 갱신하는 처리다.
핵심 포인트! Multi-AZ는 "죽지 않게", Read Replica는 "덜 붐비게", 캐시는 "덜 계산하게" 만드는 장치다. 세 가지가 구분되는 이유는 복제 방식이 다르기 때문이다. Multi-AZ는 동기 복제로 장애 시 데이터 유실을 줄이는 대신 대기 DB를 조회에 쓰지 않고, Read Replica는 비동기 복제로 읽기를 나누는 대신 잠깐 옛날 값을 보여줄 수 있다. 그래서 재고나 결제처럼 정확한 값이 중요한 작업은 복제본이나 캐시가 아니라 원본 DB와 트랜잭션을 기준으로 설계하게 된다. 조회가 느리다고 캐시부터 붙이기보다 느린 SQL, 인덱스, 불필요한 반복 조회를 먼저 확인하는 것도 같은 이유다.
4. VPC · 보안 그룹 · IAM — 네트워크 접근과 실행 권한을 구분하자#
VPC는 AWS 안에 만드는 가상 네트워크이고, 서브넷은 그 네트워크를 나눈 구역이다.
퍼블릭 서브넷은 인터넷 게이트웨이로 가는 경로가 있는 서브넷이다. 하지만 그 안에 있다고 모든 서버가 자동으로 인터넷에 공개되지는 않는다. 퍼블릭 IP, 라우팅, 보안 규칙이 함께 맞아야 한다. 프라이빗 서브넷은 인터넷 게이트웨이로 직접 가는 경로가 없다.
대표적인 웹 서비스 구성은 인터넷 요청을 받는 ALB를 퍼블릭 서브넷에 두고, 애플리케이션과 DB는 프라이빗 서브넷에 두는 방식이다. 내부 서버가 외부 API에 접속해야 하면 NAT Gateway를 검토하고, S3 같은 AWS 서비스에는 VPC Endpoint를 통한 사설 접근도 고려할 수 있다.
보안 그룹은 어떤 네트워크 연결을 허용할지 정한다. DB 포트를 전 세계에 여는 대신, 애플리케이션 보안 그룹에서 오는 연결만 허용할 수 있다.
IAM은 누가 어떤 AWS 작업을 할 수 있는지 정한다. 서버가 S3 파일을 읽으려면 네트워크 연결만으로는 부족하고, 그 작업을 허용하는 IAM 권한도 있어야 한다.
- 보안 그룹: "이 서버에 이 포트로 연결해도 되는가?"
- IAM: "이 주체가 이 S3 객체를 읽어도 되는가?"
핵심 포인트! 보안은 "닿을 수 있는가(네트워크)"와 "해도 되는가(권한)" 두 겹으로 이루어진다. 이렇게 나뉘어 있는 이유는 둘이 막는 공격이 다르기 때문이다. 보안 그룹이 열려 있어도 IAM 권한이 없으면 S3를 읽을 수 없고, IAM 권한이 있어도 네트워크가 막혀 있으면 닿지 못한다. 그래서 애플리케이션에는 IAM Role로 필요한 범위의 임시 자격 증명만 주는 것이 기본이 된다. 최소 권한은 "일단 관리자 권한을 주고 나중에 줄이자"가 아니라 "필요한 작업과 리소스만 허용하자"는 원칙이다.
DB 비밀번호 같은 비밀값은 Secrets Manager 등으로, HTTPS 인증서는 ACM으로 관리할 수 있다. 다만 관리형 저장소를 써도 접근 권한을 넓게 주면 안전해지지 않는다.
5. ALB · Auto Scaling · Multi-AZ — 트래픽 증가와 장애에 대응하자#
ALB는 HTTP · HTTPS 요청을 여러 서버로 분산하는 로드밸런서다. Auto Scaling은 설정한 지표와 정책에 따라 서버 수를 늘리거나 줄인다.
둘의 역할은 다르다. ALB만 추가한다고 서버가 늘어나지 않고, 서버만 늘린다고 요청이 고르게 나뉘지도 않는다. 요청을 처리할 수 있는 서버인지 확인하는 헬스 체크도 함께 설정해야 한다.
서버를 늘리기 전에 확인할 것이 있다. 사용자 세션이나 파일이 특정 서버에만 묶여 있지 않은가? 로그인 정보를 한 서버의 메모리에만 저장했다면, 다음 요청이 다른 서버로 가는 순간 로그인이 풀린다. 2번에서 파일을 S3로 분리한 것도 결국 같은 이야기다.
AZ는 한 리전 안에서 물리적으로 분리된 인프라 구역이다. 여러 AZ에 서비스를 나눠 두면 한 AZ의 장애에 대비할 수 있다.
핵심 포인트! 확장과 장애 대응은 "서버가 몇 대인가"가 아니라 "한 대가 사라졌을 때 사용자 요청이 어떻게 처리되는가"로 설명해야 한다. 이렇게 봐야 하는 이유는 ALB · Auto Scaling · Multi-AZ가 각각 분산 · 증감 · 물리적 격리라는 서로 다른 조각만 맡기 때문이다. 세 조각이 맞물리려면 서버가 상태를 갖지 않아야(세션 · 파일 외부화) 하고, 헬스 체크로 고장 난 서버를 빼낼 수 있어야 한다. 그리고 Multi-AZ가 있어도 잘못된 배포나 데이터 삭제는 막지 못한다. 그건 백업과 복구 절차의 영역이다.
6. SQS — 느린 작업을 사용자 응답에서 분리하자#
주문 API가 이메일 발송까지 기다린다면, 메일 시스템이 느려지는 순간 주문 응답도 느려진다.
SQS는 작업 메시지를 큐에 보관해 소비자가 나중에 처리하게 하는 서비스다. 주문 저장과 알림 발송을 분리하면 사용자는 주문 결과를 먼저 받고, 워커가 알림을 처리한다. 작업이 갑자기 몰려도 큐가 완충 역할을 한다.
다만 표준 큐는 순서와 중복 없는 전달을 보장하지 않는다. 같은 작업이 다시 도착할 수 있으니, 주문 ID 같은 기준으로 이미 처리했는지 확인해야 한다. 같은 요청을 여러 번 처리해도 결과가 한 번 처리한 것과 같은 성질을 멱등성이라고 한다. 실패가 반복되는 메시지는 DLQ(Dead-Letter Queue)로 분리해 원인을 조사한다.
핵심 포인트! 큐를 붙이면 응답 속도는 얻지만 "정확히 한 번"은 공짜로 얻지 못한다. 그 이유는 분산 환경에서 메시지 전달은 "최소 한 번"이 현실적인 기본값이기 때문이다. 네트워크가 끊기거나 처리 확인이 늦으면 같은 메시지가 다시 전달될 수 있다. 그래서 중복 방지는 큐가 아니라 애플리케이션의 멱등 처리로 완성되고, FIFO 큐의 순서 · 중복 제거 기능을 쓰더라도 결제나 메일 같은 실제 처리의 중복은 애플리케이션에서 다시 막는다. 주문을 DB에 저장한 뒤 메시지 전송만 실패하는 경우도 있으니, 큐를 붙이는 것과 업무 전체의 정합성을 보장하는 것은 별개의 과제다.
7. CloudWatch · CloudTrail · 비용 — 배포 이후를 보자#
| 서비스 | 답하는 질문 | 보는 것 |
|---|---|---|
| CloudWatch | "API 응답이 왜 느린가?" | 지표 · 로그 · 알람 (오류율, 응답 시간, CPU, 큐 대기량) |
| CloudTrail | "누가 보안 설정을 바꿨는가?" | AWS API 활동 기록 (작업 주체와 변경) |
| Budgets | "예산을 넘을 것 같은가?" | 예산과 알림 |
| Cost Explorer | "돈이 어디서 나가고 있는가?" | 발생한 비용 분석 |
CloudWatch로 사용자가 불편을 겪는 상황을 파악하려면, 애플리케이션 로그 수집과 필요한 지표를 직접 설정해야 한다. 자동으로 다 보이는 것이 아니다.
핵심 포인트! 배포는 끝이 아니라 관찰의 시작이고, 비용도 운영의 일부다. 예산 알림을 만들었다고 그 금액에서 서비스가 자동으로 멈추지는 않는다. 비용은 반영과 알림에 지연이 있어서, 알림이 왔을 때는 이미 넘은 뒤일 수 있다. 그래서 개발 환경에서는 미사용 서버뿐 아니라 NAT Gateway, 로드밸런서, 저장소와 스냅샷, 로그 보관량, 데이터 전송 비용까지 확인하고, Auto Scaling에도 최대 실행 개수를 정해두는 구조가 만들어진다. 시간당 요금이 붙는 리소스는 쓰지 않아도 켜져 있는 동안 계속 과금된다.
AI가 설정을 만들어줘도 직접 판단하는 다섯 가지#
배포 코드와 설정을 쓸 때 AI의 도움을 받을 수 있다. 대신 결과물을 아래 질문으로 검토한다. 공부하면서 이 다섯 질문이 앞의 일곱 묶음을 한 번에 꿰는 체크리스트라는 걸 알게 됐다.
- 공개 범위 — 인터넷에 열어야 하는 것은 무엇이고, DB가 직접 노출되지는 않는가? (4번)
- 권한 범위 — 애플리케이션에 필요한 리소스와 작업만 허용했는가? (4번)
- 데이터 정확성 — 캐시가 오래되거나 작업이 중복돼도 문제가 없는가? (3번 · 6번)
- 복구 방법 — 배포 실패나 데이터 삭제가 생기면 무엇을 되돌릴 것인가? (5번)
- 운영 근거 — 어떤 로그 · 지표로 성공을 확인하고 비용을 감시할 것인가? (7번)
핵심 포인트! 경험을 설명할 때는 "AWS를 써봤다"보다 "어떤 문제 때문에 무엇을 골랐고, 무엇으로 효과를 확인했는가"가 구체적이다. 예를 들어 "이미지를 S3로 분리하고 CloudFront 캐시를 적용해 원본 요청을 줄였다. 배포 후 파일 갱신을 위해 버전이 포함된 파일명을 사용했다"처럼 말할 수 있다. 다만 효과를 수치로 말하려면 적용 전후의 로그와 지표가 있어야 한다. 지표 없이 "빨라졌다"고만 하면 근거가 없는 문장이 된다.
요런 건 주의하자!#
공부하면서 내가 실제로 헷갈렸거나, 처음에 틀리게 적었다가 공식 문서를 보고 고친 것들이다.
- "서버리스 = 서버가 없다" ❌ — 서버 관리를 AWS가 대신할 뿐이다. 항상 실행되는 서비스가 Lambda에서 무조건 더 싼 것도 아니다.
- "S3 정적 호스팅에 Next.js를 올리면 SSR도 된다" ❌ — 정적 파일 저장과 서버 코드 실행은 다른 문제다.
- "OAC를 붙이면 사용자 인증도 된다" ❌ — OAC는 CloudFront → S3 원본 접근을 제한할 뿐, 최종 사용자의 로그인 권한은 검사하지 않는다.
- "Presigned URL만 발급하면 업로드 보안 끝" ❌ — 권한 확인, 저장 경로, 파일 크기 · 형식 제한은 여전히 서버가 정한다.
- "Multi-AZ 대기 DB로 조회를 분산한다" ❌ — Multi-AZ DB 인스턴스의 대기 DB는 장애 대응용이다. 읽기 분산은 Read Replica, 또는 별도의 Multi-AZ DB 클러스터 구성을 본다.
- "Read Replica는 항상 최신 값이다" ❌ — 비동기 복제라 지연이 있다.
- "느리면 일단 캐시" ❌ — 느린 SQL, 인덱스, 반복 조회를 먼저 본다. 캐시는 최신성 관리라는 숙제를 같이 가져온다.
- "퍼블릭 서브넷에 두면 자동으로 공개된다" ❌ — 퍼블릭 IP, 라우팅, 보안 규칙이 함께 맞아야 한다.
- "보안 그룹을 열었으니 S3도 읽힌다" ❌ — 네트워크 허용과 IAM 권한은 별개다.
- "ALB를 붙이면 서버가 늘어난다" ❌ — 증감은 Auto Scaling의 일이고, 세션이 서버에 묶여 있으면 늘려도 문제가 생긴다.
- "Multi-AZ니까 백업은 필요 없다" ❌ — 잘못된 배포나 데이터 삭제는 그대로 복제된다.
- "SQS가 중복을 막아준다" ❌ — 표준 큐는 중복 전달이 가능하다. 멱등 처리는 애플리케이션 몫이다.
- "Budgets 금액을 넘으면 자동으로 멈춘다" ❌ — 알림일 뿐이고, 반영에도 지연이 있다.
개념 이해는 출발점일 뿐이다. 다음에는 작은 프로젝트 하나에 이 중 한 가지 구성을 직접 적용하고, 장애 · 권한 · 비용까지 확인해볼 생각이다. 그래야 "알고 있다"가 "설명할 수 있다"로 바뀐다.
참고#
AWS SAA-C03 학습 자료에서 웹 서비스 운영과 관련된 내용을 골라 정리했고, 헷갈리기 쉬운 설명은 아래 공식 문서로 확인했다.